
Reranker 完成排序後,我們手上已經有一份依相關程度重新排列過的片段清單。但這還不是答案,只是「找到的資料」。接下來要解決的問題是:這些資料該如何交給語言模型,讓它據此產生真正回答使用者問題的內容?這正是今天要談的 Context 與 Generation。
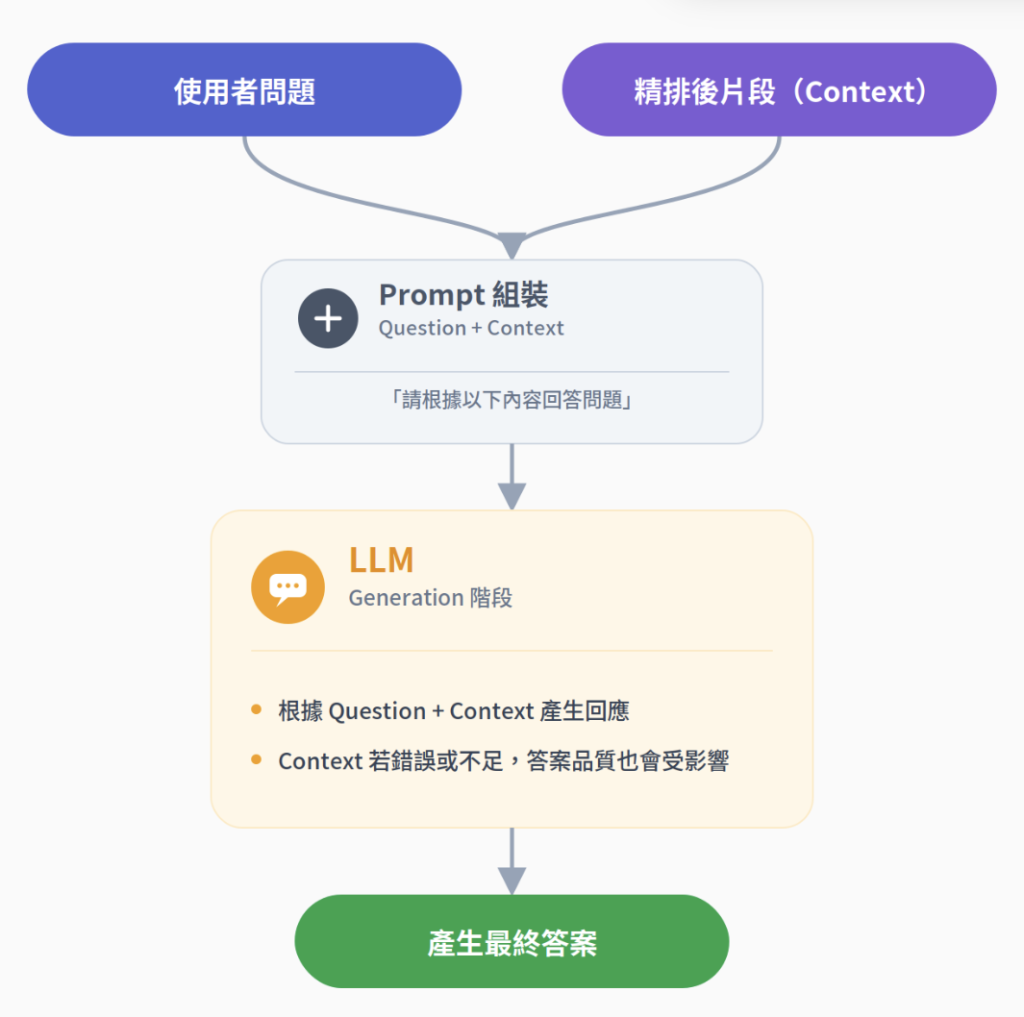
先延續上一篇的例子。假設使用者問「特休一天需要提前幾天申請?」,Retriever 從知識庫中找回二十個候選片段,經過 Reranker 重新排序後,系統通常不會把這二十筆內容全部送進語言模型,而是依照排序結果,選出排名最前面的幾筆——例如前五筆。這些被選出來、準備提供給模型參考的內容,就是 Context。組裝的方式並不複雜:把挑選出的片段串接成一段文字,連同使用者原始的提問一起送入模型,並透過提示詞明確告訴模型「請根據以下內容回答問題」。這個組合起來的輸入,就是語言模型接下來實際看到的東西。
這裡容易產生一個疑問:既然最終仍然是交給語言模型生成回應,為什麼不直接把問題丟給它就好?這其實回到了 Day1 提到 RAG 存在的理由。語言模型的知識來自訓練資料,這些資料有其時間範圍,也不太可能涵蓋某間公司內部、且經常異動的請假規章。像「特休一天需要提前幾天申請」這類規定,通常存在於員工手冊、HR 的標準作業流程,或是內部知識庫裡,而不是語言模型原本就學過的內容。RAG 要做的事情,正是在生成回應之前,先從外部知識來源取得與當下問題相關的資料,讓語言模型不只仰賴自身既有的知識,也能參考當下檢索到的第一手內容。這也是「Retrieval-Augmented」這個名稱的由來——用檢索到的資料去增強生成的過程。
值得特別留意的是,Context 並非越多越好。假設最後提供給語言模型的內容,除了與請假規定直接相關的片段之外,還混入了出勤異常處理規範、員工旅遊辦法、加班申請規定、薪資計算方式等一堆同樣來自公司文件、但與這次提問無關的片段。這些內容雖然「看起來」都是合理的候選,真正切題的往往只占其中一小部分,其餘的不僅會拉長輸入內容、增加運算與費用負擔,也會讓模型更難聚焦在真正重要的資訊上,甚至可能被無關內容干擾而答非所問。因此 Retriever 與 Reranker 存在的意義,就是盡量把最終送進模型的內容控制在「足夠且相關」的範圍內,而不是單純地「越多越好」。
Context 的品質,也直接決定了 Generation 階段所能達到的上限。即使語言模型的理解與生成能力再強,只要提供給它的內容本身就是錯的或不相關的,產生出來的回應自然也很難正確。舉例來說,若使用者問的是「特休一天需要提前幾天申請?」,但 Retriever 因為語意相近,找到的其實是「特休未休畢時數如何結算」的規定,即使語言模型能夠完美理解這段文字、並且忠實地根據它作答,最後產生的答案仍然會答非所問——因為問題根本不在語言模型有沒有讀懂內容,而是它從一開始就被交付了錯誤的參考資料。換句話說,回答錯誤的原因,很可能早在生成階段之前、就已經發生在檢索階段了。
這也是為什麼我們需要把 Retrieval 與 Generation 視為兩個雖然相連、卻各自獨立的階段來看待。Retrieval 由 Retriever 與 Reranker 共同負責,任務是「找到與問題相關的資料」;Generation 則由語言模型負責,任務是「根據問題與找到的資料,產生答案」。當最終的答案出現問題時,究竟是資料一開始就沒找對,還是資料找對了、但語言模型沒有正確理解或運用這些資料,會是完全不同性質的問題,也需要用不同的方式去檢視與排除。如果只盯著最後產生的答案本身,我們其實很難判斷問題出在流程中的哪一個環節。


 iThome鐵人賽
 看影片追技術